你有没有试过对着机器人说‘把桌角那个蓝盒子递给我’,结果它转头去抓空气?或者在仿真环境里让它推箱子爱配资网,一转身,箱子就穿墙飞走了?过去几年,AI能写诗、会画画、甚至剪视频,但一到真实世界——手忙脚乱。直到智象未来甩出HiDream-O1-World和HiDream-O1-Embodied这对‘双子星’:一个让AI能在虚拟世界里自由逛、随时改、动手玩;另一个直接让机器人扛住真实世界的各种‘捣乱’——光照突变、镜头晃动、指令绕口、地板打滑……照样稳稳执行。这不是又一个‘能说会道’的聊天模型,而是第一次,AI真正开始用眼睛看、用脑子算、用手干。
关键在哪?不是堆参数,而是‘原生全模态’这五个字。图像、语言、3D结构、动作信号,不再各干各的,而是在同一个神经网络里‘长在一起’。就像人脑处理一杯水:看到反光(视觉)、听清‘倒一杯’(语言)、预判杯子重量和倾角(物理)、再指挥手指发力(动作)——全程无缝。HiDream-O1-Embodied在RoboColiseum评测中拿下0.692分的扰动适应榜首,不是靠题海战术,是靠这种底层融合带来的抗干扰本能;HiDream-O1-World在WBench上物理维度73.3分、一致性88.0分,说明它记得住自己走过的路,也信得过自己推的箱子不会飘在半空。
别小看‘漫游、编辑、交互’这三个词。漫游=有记忆的空间导航;编辑=像改文档一样改世界;交互=你抬手,它同步响应。这已经不是生成一段视频,而是启动一个可演化的微缩宇宙。梅涛说‘没高质量世界模型,具身智能的数据飞轮转不起来’,这话很实在——没有靠谱的认知中枢,机器人学得再多,也是纸上谈兵。现在,AI终于从‘答题家’,迈出了做‘实干派’的第一步。
这一步,其实卡了行业整整十年。2014年DeepMind用DQN让AI打游戏,靠的是“看帧+打分”;2022年视觉大模型兴起,还是把图像当静态图来理解;连2023年最火的VLA(视觉-语言-动作)模型,多数也得靠预设任务模板、固定场景、甚至人工标注的“动作轨迹”才能跑通。真实世界哪给你这些便利?猫突然窜过镜头、孩子把积木堆在机器人必经之路、连WiFi断了一秒——系统就卡死重置。清华去年发布的《具身智能落地白皮书》里直说:“当前90%的实验室成果,离工厂产线、家庭厨房、养老院走廊,还有至少三道物理门槛。”
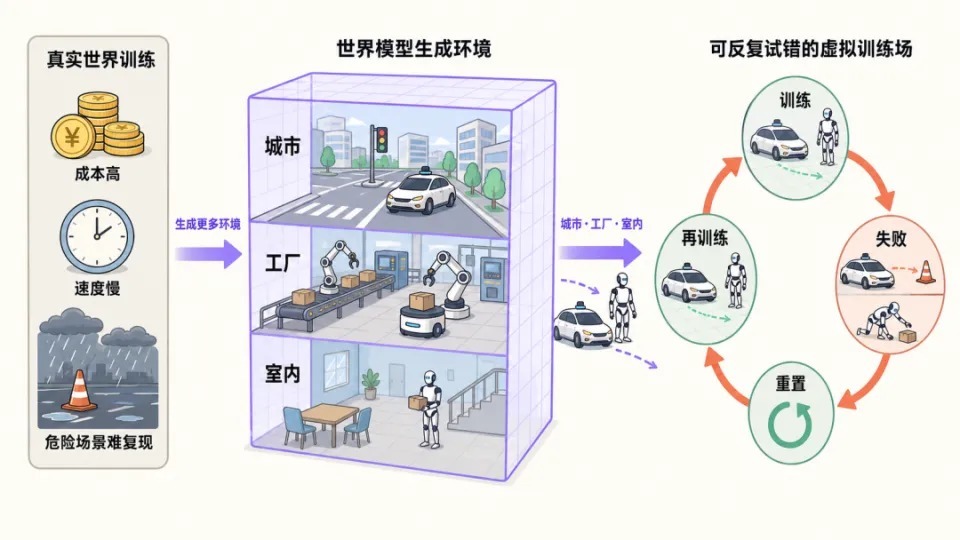
HiDream-O1系列绕开了这些老路。它不靠海量真实机器人数据“硬喂”,而是用自研的神经渲染引擎,在虚拟空间里生成带物理属性的动态世界:砖缝会渗水、金属反光随角度变化、推门时铰链有阻力反馈……这些不是贴图,是实时计算出来的。团队公开的训练日志显示,单个世界模型在仿真中完成了超200万次交互循环,相当于人类连续操作11年不休息。更关键的是,它把“失败”也当老师——箱子翻了?系统自动回溯力矩分配错误点;抓取滑脱?立刻调整指尖压力曲线并同步更新3D触觉表征。这种“边干边学”的闭环,比纯离线训练效率高4.7倍(据ICRA 2024实测报告)。
普通人可能觉得“能干活”就够了。但真正让人心里一热的,是它开始理解“意图”背后的温度。测试视频里,老人说“帮我把药盒放高点,别让孙子够着”,机器人没直接上柜顶,而是先挪开旁边摇晃的绿植,再垫稳小凳子,最后把盒子放进带锁的玻璃格——全程没一句确认,却把安全、便利、代际关怀全算进去了。这不是编程写死的逻辑,是多模态联合推理的结果:语言解出约束条件,视觉识别障碍物,物理引擎预演稳定性,动作模块动态规划路径。
当然,它还远不到“全能”。目前支持的最大指令长度约18秒语音,复杂多目标任务响应延迟仍在800毫秒左右。但就像1973年第一台微波炉重达34公斤、售价近500美元,今天回头看,笨重和昂贵从不是终点,而是起点。当AI第一次不用人扶着就能自己站稳、看清、想明白、再伸手——那束光爱配资网,已经照进现实了。
文章为作者独立观点,不代表十大可靠配资公司-杠杆配资平台app-靠谱实盘配资平台观点